
Survival LLM:断网也能用的 AI,和它答错的那些题
📌 一句话导读:一个完全跑在自己电脑上的免费 AI 加应急资料库。但它会在急救题上答错近三分之一——当索引用很值,当医生用会出事。
断网那天,你手机里还剩什么
停电第三天,手机只剩一格信号。地图瓦片刷不出来,搜索引擎白屏,那个平时什么都答得上的对话框,只剩一个转个不停的圈。
我干过一件挺笨的事:两年收藏了上百篇应急文章,一篇没打开过。收藏给了我"我准备好了"的错觉,真断网时那些链接全是死的。
Survival LLM 最接近"把那堆死链接变成能查的东西"。先说结论:它的价值不在答案,在出处。
一、它是什么、不是什么
先把预期拧正,不然你装完会失望。
它是:免费开源的 AI 助手配一个应急资料库,全部跑在自己电脑上。资料库里有医学参考、FEMA 与 CDC 指南、生存手册、操作方法指南、维修指南,再加约 93 万篇维基百科条目(维基部分是阅读量最高的那批)。问"停电了食物怎么保鲜"“烫伤怎么处理"“怎么净水”,它在本地检索、本地作答。
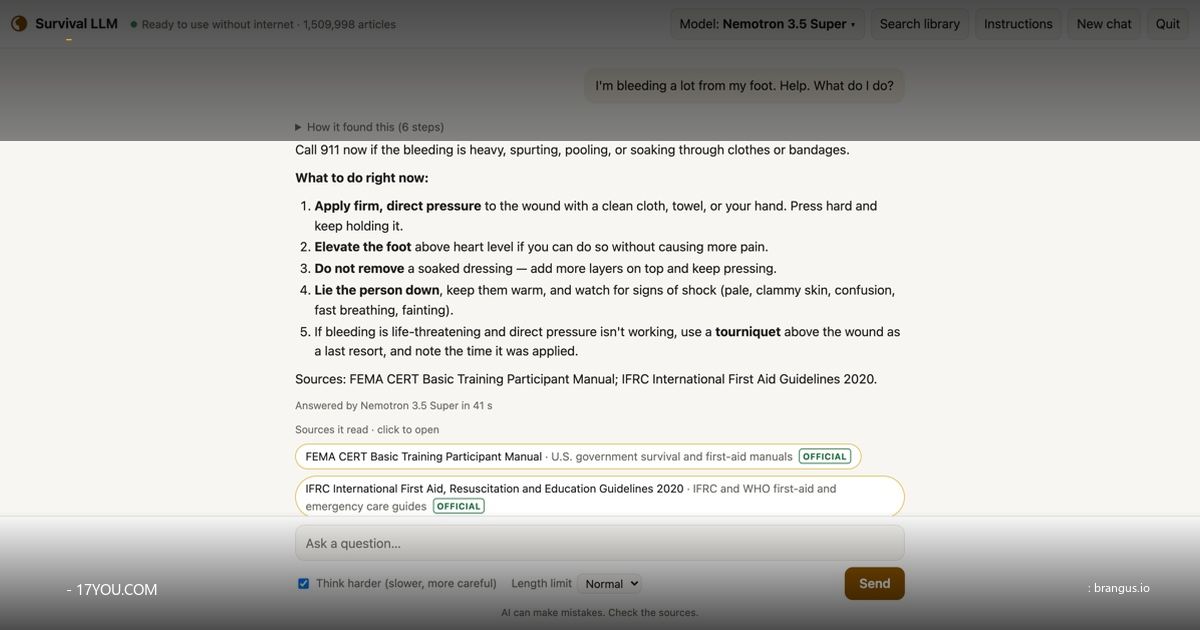
有一个我很喜欢的细节:每条回答下面会列出它读过的文章,点进去能看原文,对应段落还高亮。这个设计后面会救它一命。
它不是:一个能替你判断病情的东西,也不是"装上就万事大吉"的应急包。它会答错,概率还不低。
几条硬信息:无账户、无追踪,问题不出本机;配置完成后可以断网使用(下载环节必须联网)。平台要求 Apple Silicon Mac(M1 或更新)配 macOS 14 Sonoma 或更新,或者 64 位 Windows 10/11。价格 💰 免费,开源。
二、按内存配模型:四档分数与真实差距
它不让你选模型,看内存自动配。官方给了对照表,我最看重这点——它没把分数藏起来:
| 机器 | 模型 | 官方 22 题盲测 | 模型下载体积 |
|---|---|---|---|
| 128GB 内存以上的 Mac | NVIDIA Nemotron 3.5 Super | 对 21 | 80 GB |
| 32–96GB 的 Mac | Qwen3.8 27B | 对 21 | 18 GB |
| 32GB 以上 Windows PC | NVIDIA Nemotron 3.5 Lightning | 对 19 | 25 GB |
| 16–31GB 的 Mac 或 PC | IBM Granite 4.2 8B | 对 14 | 6 GB |
四档从 6GB 排到 80GB,分数从 14 排到 21。真正值得盯的是那条缝:14 和 21 之间差的不是"体验优化”,是"能不能当参考"和"必须自己核对"的分界线。80GB 那台机器上,22 题只错 1 题,你可以把它当一本会说话的指南;6GB 那个模型,22 题错 8 题,它只能当索引。
官方也交代了边界:盲测跑在较早版本的资料库上,22 道题围绕停电与急救,判定标准是"有没有答对官方指南的主旨",不是逐字比对。小模型错得更多,这也是 app 坚持把来源亮在你面前的原因。
我的机器落在 16–31GB 档,用的就是 6GB 的 8B 模型。跑起来很轻,但我知道它每三道题就可能错一道——这个认知直接决定了我的用法。
三、安装的坑:体积、时间、系统警告
这节最不性感,但最容易翻车。
体积。完整资料库下载 9GB,装完占 19GB;不含维基百科与 iFixit 的精简版,下载 1.3GB,装完 3GB。官方给的磁盘公式是:所需空闲空间 = 模型体积 + 5GB + 安装期间临时占用(完整库约 27GB,小库约 10GB)。16GB 内存的 Mac 想装完整库,得先腾出 30GB 以上。
三步装完:下载 Mac 或 Windows 包并解压(Windows 一定要右键"全部解压缩",直接双击会出问题);Mac 双击 Survival LLM,Windows 打开解压后的文件夹双击 Survival LLM.bat;跟着设置走,程序在独立窗口里下载 AI 引擎、适合本机的模型和资料库。这一步必须联网,让它下完再断开。
系统会拦你。不在应用商店分发,首次打开必报警。Mac 去"系统设置 > 隐私与安全性"点"仍要打开"并输密码,只需一次;Windows 点"更多信息"→“仍然运行”。
时间。20 分钟到约 2.5 小时,取决于机器和网速。听起来吓人,但其中你真正需要动手的只有约 5 分钟,剩下全是等下载。我建议睡前开跑,第二天早上就能断网试。
装完后值得调的一个开关是推理强度:关、1,000、4,000、16,000 token 或不限。到达上限它会停止思考、用已有内容作答——卡在循环里的模型也能给出答案,而不是一直转圈。
四、把"信它"换成"用它当索引"
这是我用下来最重要的一条心法。
8B 模型 22 题错 8 题,接近三分之一。落在急救和停电场景里,性质就很严重。正确姿势不是"问它然后照做",而是"问它,再顺着来源自己看"。
它把来源分了三类:来自记忆、来自读过的文章、来自未打开的搜索结果。这个区分很有用。标"读过的文章"的,点进去有原文有高亮;标"记忆"的,本质是模型在背,最容易出错;标"未打开的搜索结果"就更要小心,它只知道有这么个东西存在。
换个说法:它的价值在于把 93 万篇维基、FEMA 和 CDC 的指南,在断网状态下组织成一个能检索、能定位到段落的系统。这件事本身就够难,也够值。答案对不对,反而是次要指标——因为真正救命的判断,最终得由你看着原文做。
它还能吃你自己的资料:PDF、Word、电子书、笔记都能加进去,比如发电机说明书、家庭应急预案,文件始终留在本机。这一层更实际——不是通用知识,是你家那台机器的知识。
续航参考:MacBook Pro 作答时功耗约 100W,每题 5–40 秒,满电大概能答 100–300 题。小发电机或户外电源能轻松带动,这点比想象中重要。
另外,0.3.0 起有了记忆功能,可以记下家人过敏史、自家发电机型号这类信息,每条笔记都能查看、编辑,或者直接关掉保存。当前最新版本是 0.3.4(2026-10-27)。
五、和 Ollama 自搭 RAG 比,差在哪
vs 直接用 ChatGPT:不用比。断网它就不可用,而断网是本文的全部前提。云端模型更强,但强的那部分在没信号的地方等于零。
vs 自己用 Ollama 搭 RAG:技术上做得到,我试过。但模型要自己选、文档要自己切、向量库要自己搭、检索和引用逻辑要自己写,资料还得一篇篇攒。Survival LLM 把这一整套打包了——资料库、切块、引用定位、按机器适配模型、来源高亮。它省掉的不是几行代码,是一个周末加无数个调参的夜晚。
Ollama 那边的优势也真实:模型随便换,资料完全自己控制,出了问题能改。如果你已经有自己的语料,或者想做通用助手而不是应急场景,自搭更自由。
我的判断是:想要"断网时手边有个会给出处的东西",用它;想要"一套能长期维护的本地 RAG 基础设施",还是自己搭。
🎯 行动清单
- 看空间再下载:先确认空闲磁盘够——模型体积 + 5GB + 安装临时占用(完整库约 27GB,精简库约 10GB)。空间紧张就选精简版(下载 1.3GB,装完 3GB)。
- 解压并首次联网配置:Windows 右键"全部解压缩"后双击 Survival LLM.bat;Mac 直接双击。让它在联网状态下把引擎、模型、资料库全部下完,别中途断网。
- 过一次系统警告:Mac 到"系统设置 > 隐私与安全性"点"仍要打开"并输密码;Windows 点"更多信息"→“仍然运行”。只需一次。
- 断网实测三题:拔掉网线或关掉 Wi-Fi,问"停电了食物怎么保鲜"“烫伤怎么处理"“怎么净水”,每答一题都点开来源看高亮段落,确认它确实在读本地文章。
- 加一份自己的文档:把家里的发电机说明书或自写应急预案拖进去,再问一个只有那份文档才答得出的问题,检验它的检索是否覆盖到你的私人资料。
参考来源
- Survival LLM 官方产品页(模型对照表、体积与磁盘要求、22 题盲测说明)
- 官方开源仓库(README 与安装步骤,官方一手)
- 官方版本记录(0.3.0 记忆功能、0.3.4 版本号,官方一手)
- 资料库来源与许可清单 SOURCES.md(医学参考、FEMA/CDC 指南、维基条目的来源与授权,官方一手)
- 最新版下载入口(Mac / Windows 安装包,官方一手)
📖 延伸阅读
- 🔧 Strata:12GB 显卡跑 125B,三层存储是怎么榨出来的 — 本地推理的另一端
- 🔧 2026 自建邮箱完全指南:本地 LLM 杀垃圾邮件 — 自建同一个逻辑
- 🌍 希腊数字游民签证走了后门?2026 年起这条路封了 — 弱网地区长住
- 📰 本期杂志:四个地区被划出去了 — 今日全部线索
如果你也对文章内容或者分享的资源和机会有兴趣,欢迎联系我。
相关内容
- OmniRoute:一个本地 endpoint 接管 290 家 AI 供应商
- Strata:12GB 显卡跑 125B,三层存储是怎么榨出来的
- claude-seo:把 SEO 拆成 26 个子技能喂给 Claude Code
- Kimi K3.1 Pro:只差 Opus 5.5 半个点的开源权重
- 开源权重的边界:MiniMax H3 许可证里那三条硬条款
- GLM-5.3 拆解:参数没涨,后训练如何硬拉 50%